What is active_mm?
Table of contents
lazy_tlb
User process A (Task A)의 페이지 테이블에는 Userspace mapping과 Kernelspace mapping이 함께 들어 있다. 반면 Kernel thread K는 (kthread) Userspace mapping 없이 Kernelspace mapping만 있으면 실행할 수 있다.
따라서 Task A에서 kthread K로 전환할 때는 A의 페이지 테이블을 그대로 MMU에 남겨 두어도 K가 실행되는 데 아무런 문제가 없다.
Linux 커널은 Context switch 과정에서 이 점을 활용한다. 다음에 스케줄될 task가 kthread라면 굳이 비용이 비용이 큰 주소 공간 전환(Root page table 교체1와 그에 따르는 TLB flush)을 수행하지 않고, 직전에 실행되던 주소 공간을 그대로 ‘빌려’ 쓴다. 이를 lazy TLB mode라 부른다.
What is meaning of borrowing address space?
kthread로 전환할 때는 새로운 페이지 테이블을 로드하지 않고, 직전 User task의 페이지 테이블을 MMU에 그대로 유지한 채 어떤 주소 공간를 빌려 쓰고 있는지만 기록해 둔다.
User task의 페이지 테이블에 이미 Kernelspace mapping이 포함되어 있기 때문에 가능한 방식이다.
이를 위해 task_struct에는 태스크 고유의 주소 공간을 가리키는 mm 외에, 현재 CPU 코어의 MMU에 실제로 로드된 컨텍스트를 가리키는 active_mm 멤버 변수를 별도로 둔다. 구체적인 동작은 아래 예시를 통해 살펴보자.
[!Warning] x86 예외 active_mm이 실제 하드웨어 (TLB, page table)에 로드된 주소 공간을 가리킨다는 정의는 Linus의 1999년 설명과 대부분의 아키텍처에서는 맞지만, x86은 의도적으로
current->active_mm을 실제 CR3 상태와 동기화하지 않는다. 7.0 kernelarch/x86/mm/tlb.c:777-782의 주석이 그 점을 명시하고 있는데, x86은 실제 로드된 mm을 per-CPUcpu_tlbstate.loaded_mm으로 따로 추적한다.
Example
예를 들어, CPU 0이 User task A를 실행하고 있다고 가정하자. 이 때, mm과 active_mm은 서로 같은 주소공간 mm_A를 가리킨다.
A->mm        = mm_A
A->active_mm = mm_A
CPU MMU      = mm_A
이 상태에서 CPU 0이 kthread K로 Context switch를 수행한다고 해보자. K는 자체적인 Userspace를 소유하지 않으므로 K->mm은 NULL이다. 대신 현재 CPU(MMU)에 남아 있는 Context를 K->active_mm에 기록해 둔다.
K->mm        = NULL
K->active_mm = mm_A
CPU MMU      = mm_A
강조하지만 active_mm == mm_A라고 해서 A의 Userspace를 사용(접근)할 권한을 얻었다는 뜻은 아니다.
K는 여전히 사용자 공간이 없는 kthread다. active_mm은 소유권과 무관하게 현재 MMU 상태와 그 수명(refcount)을 추적하기 위해 기록해 둔 값이다. 이를 그림으로 나타내면 다음과 같다.
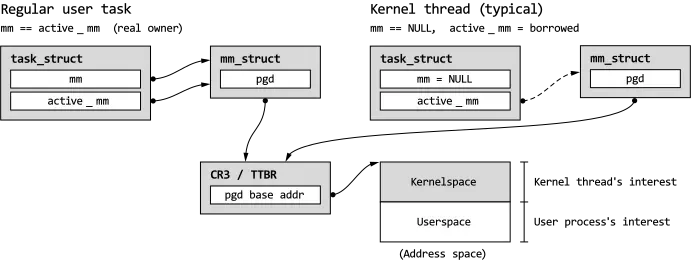
Context switch example
lazy tlb mode가 활용되는 예제를 User task A, B와 kthread K 사이의 전환 과정에서 코드와 함께 살펴보자.
A → K
User process A에서 Kernel thread K로 Context switch하는 순간을 보자. mm_A 의 페이지 테이블에는 다음 두 종류의 매핑이 이미 들어 있다.
mm_A의 페이지 테이블
├─ User mapping: A의 코드, 힙, 스택, mmap
└─ Kernel mapping: 커널 코드, 커널 데이터, 커널 스택
K가 필요한 것은 Kernel mapping뿐이다. 따라서 Userspace mapping을 바꾸거나 없앨 필요도, 별도 Kernel 페이지 테이블을 로드할 필요도 없다.
Before switch
    prev = A
    A->mm = A->active_mm = mm_A
    CPU MMU = mm_A

After switch
    next = K
    K->mm = NULL
    K->active_mm = mm_A
    CPU MMU = mm_A            // No TLB flush
kernel/sched/core.c 코드를 보면 이 경우에는 다음과 같이 Context switching 한다.
/* user -> kernel */
enter_lazy_tlb(prev->active_mm, next);
next->active_mm = prev->active_mm;

if (prev->mm)				// from user
	mmgrab_lazy_tlb(prev->active_mm);
else                        // from kernel
	prev->active_mm = NULL;
코드를 차례로 살펴보면,
-
enter_lazy_tlb()는tsk->mm == NULL인 태스크가 Lazy TLB 상태로 진입할 때 아키텍처별 후속 처리를 수행하기 위해 스케줄러가 호출하는 훅(hook)이다. 세부 구현은 ISA마다 다른데, x86의 경우loaded_mm != &init_mm이면cpu_tlbstate_shared.is_lazy플래그를 설정해 두고, 이후switch_mm_irqs_off()에서 TLB generation을 비교해 실제 flush 여부를 판단할 때 이 플래그를 참조한다. -
이어서
next->active_mm = prev->active_mm;를 통해 직전 태스크의active_mm을 그대로 이어받는다. 직전 Task가 User task(prev->mm != NULL)였다면mmgrab_lazy_tlb()를 호출해 해당 주소 공간의 참조 카운트 (refcount)를 증가시킨다. -
반면 직전 태스크 역시 Kernel thread(
prev->mm == NULL)였다면 이미 이전 전환에서 참조 카운트를 올려두었으므로, 카운트를 추가로 조작하지 않고prev->active_mm만NULL로 비워 참조를 넘겨준다.
이 Refcount는 정합성과도 관련이 있는데, 뒤에서 살펴볼 것이다.
K → B
만약 다음에 실행할 태스크가 User task B라면 실제 주소 공간 전환이 필요하다. 현재 MMU에 로드된 mm_A의 Userspace mapping은 A의 것이고, B는 자신의 주소 공간인 mm_B를 사용해야 하기 때문이다. 따라서 이 시점에 비로소 Root page table을 교체한다.
K → B

전환 전: K->mm = NULL, K->active_mm = mm_A, CPU MMU = mm_A
전환 후: B->mm = B->active_mm = mm_B, CPU MMU = mm_B
이를 코드로 보면 다음과 같다.
/* kernel -> user */
membarrier_switch_mm(rq, prev->active_mm, next->mm);
switch_mm_irqs_off(prev->active_mm, next->mm, next);
lru_gen_use_mm(next->mm);

if (!prev->mm) {			// from kernel
	/* will mmdrop_lazy_tlb() in finish_task_switch(). */
	rq->prev_mm = prev->active_mm;
	prev->active_mm = NULL;
}
여기서 호출하는 switch_mm_irqs_off()가 Page table root와 ISA별 ASID/PCID 상태를 교체해 실제 주소 공간을 전환하는 함수다.
이처럼 lazy TLB mode는 A → K 구간의 불필요한 전환을 건너뛰고, 실제 유저 공간이 바뀌는 K → B 구간에서만 한 번 전환을 수행한다.
active_mm refcount
mm_struct에는 refcount가 두 개 있다.
하나는 mm_users로, 주소 공간을 실제로 쓰는 사용자 수이다. 사용자 수가 감소할 때마다 mmput()으로 mm_users를 감소시키며, 이 값이 0이 되면 exit_mmap()으로 VMA와 유저 페이지가 정리된다.
static inline void __mmput(struct mm_struct *mm)
{
	VM_BUG_ON(atomic_read(&mm->mm_users));
	...
	khugepaged_exit(mm); /* must run before exit_mmap */
	exit_mmap(mm);
	...
	mmdrop(mm);
}

/*
 * Decrement the use count and release all resources for an mm.
 */
void mmput(struct mm_struct *mm)
{
	might_sleep();

	if (atomic_dec_and_test(&mm->mm_users))
		__mmput(mm);
}
두번째로는 mm_count가 있으며, 이는 mm_struct 자체에 대한 참조 수이다. mmgrab(), mmdrop()을 이용해 증가/감소시키고, 0이 되면 __mmdrop()이 pgd(페이지 테이블 루트)와 mm_struct를 해제한다.
Why we need refcount?
프로세스가 종료되어 mm_users가 0이 되더라도, 어떤 CPU에서 커널 스레드가 그 mm을 active_mm으로 잡고 있다면 (빌려 쓰고 있다면) 그 CPU의 MMU context (CR3,TTBR 등)는 여전히 그 pgd를 가리키고 있어 함부로 mm_struct를 해제할 수 없다.
안전하게 mm_struct를 해제하기 위해서는 모든 CPU의 MMU context가 이 주소 공간에서 떠난 것을 확인한 뒤 비로소 해제 작업을 수행할 수 있는데, mm_count는 이 목적을 위해 참조를 추적하는 refcount이다.
mm_struct를 해제하는 시점과 refcount를 관리하는 방법은 Kernel config에 따라 다음 두 가지로 나뉜다.
method 1: refcount (기본값)
가장 단순한 방법은 주소 공간을 빌릴 때마다 mm_count를 올리고(mmgrab_lazy_tlb()), lazy 모드에서 빠져나올 때 mmdrop_lazy_tlb()로 내리는 것이다. 마지막 참조가 사라져야 __mmdrop()이 불리므로 정확성은 자명하게 보장된다. 대부분 이 방식을 쓴다.
그러나, 다수의 스레드가 존재하는 프로세스가 CPU마다 user thread → idle (kernel thread) → user thread 전환을 반복하면, 매 전환마다 동일한 mm->mm_count에 atomic 연산이 일어나게 되어 모든 CPU가 한 캐시라인을 두고 경합하게 되고, 이는 대형 시스템에서는 상당한 병목이 될 수 있다.
method 2: shootdown (“shoot lazies”)
이 병목을 해결하기 위해 Nicholas Piggin이 도입한 방식이다. 주소 공간을 빌릴 때는 mm_count를 건드리지 않고, 나중에 __mmdrop()이 호출되어 mm_struct 구조체를 해제하기 직전 cleanup_lazy_tlbs()를 통해 mm_cpumask(mm)에 속한 CPU들에게 (즉, 한번이라도 이 주소공간을 스케줄했던 CPU) IPI(Inter-Processor Interrupt)를 보낸다.
IPI를 받은 CPU는 현재 태스크의 active_mm이 해제 대상 mm과 일치하면 init_mm으로 switch_mm()을 수행한다. 모든 대상 CPU가 해당 주소 공간에서 떠난 것이 확인된 뒤에야 pgd와 mm_struct를 해제하므로, 매 Context switch마다 발생하던 atomic 연산 비용을 프로세스 종료 시점의 일회성 IPI 비용으로 치환한 셈이다.
이 방식이 안전하게 동작하려면 마지막 mmdrop() 시점에 해당 mm을 lazy 상태로 물고 있을 가능성이 있는 모든 CPU가 mm_cpumask(mm)에 반드시 포함되어 있어야 한다. 만약 아키텍처 구현상 cpumask 비트를 너무 일찍 지우면, IPI 대상에서 누락된 CPU가 이미 해제된 pgd를 계속 참조하는 문제가 생길 수 있다. 이를 검증하기 위한 디버그 옵션인 CONFIG_DEBUG_VM_SHOOT_LAZIES를 켜면, 해제 시점에 시스템 전체 CPU에 한 번 더 IPI를 보내 남아 있는 참조가 없는지 확인한다.
일회성이라도 IPI 오버헤드가 우려될 수 있지만, 실제 워크로드에서는 큰 문제가 되지 않는다. 수명이 짧은 프로세스는 여러 코어를 옮겨 다니지 않아 원격 CPU에 Lazy 참조를 남길 일 자체가 드물기 때문이다. 또한 TLB flush를 IPI로 처리하는 아키텍처라면 프로세스 종료 시점의 마지막 TLB flush IPI에 Lazy mm 전환까지 함께 묶어 추가 IPI를 줄일 수도 있다. 2
커밋 메시지에 따르면 이 아이디어의 원형은 2018년 Rik van Riel이 제안했던 방식에 기반하고 있다.
이 기능은 Nicholas Piggin의 패치 시리즈(PATCH v7 4/5 “lazy tlb: shoot lazies, non-refcounting lazy tlb mm reference handling scheme”)를 통해 리누스 토발즈의 Ack를 받아 Linux v6.4에 병합되었다. 같은 시리즈의 5번째 패치에서 192코어 POWER8 시스템의 Context switch 벤치마크 개선을 근거로 powerpc/64s(Book3S 64) 아키텍처에 CONFIG_MMU_LAZY_TLB_SHOOTDOWN=y가 먼저 적용되었다.
예외
kthread_use_mm()
일반적인 커널 스레드는 사용자 주소 공간을 다루지 않지만, 유저 프로세스를 대신해 일하는 커널 스레드나 workqueue work가 그 프로세스의 유저 메모리를 copy_to_user()/copy_from_user()나 pin_user_pages()로 직접 건드려야 하는 경우에는 kthread_use_mm(mm)을 사용한다.
이 함수는 커널 스레드의 tsk->mm과 tsk->active_mm을 대상 mm으로 설정하고, switch_mm_irqs_off()를 호출해 해당 주소 공간을 즉시 활성화한다.
mmgrab(mm);
tsk->active_mm = mm;
tsk->mm = mm;
switch_mm_irqs_off(old_active_mm, mm, tsk);
mmdrop_lazy_tlb(old_active_mm);
작업이 끝나면 kthread_unuse_mm(mm)을 호출해 원래 상태로 되돌린다. 여기서 tsk->mm = NULL로 되돌린 직후에도 CPU의 MMU(active_mm)는 방금까지 사용한 mm을 계속 가리키고 있다. 따라서 먼저 Lazy TLB 참조(mmgrab_lazy_tlb())를 확보한 뒤에야 kthread_use_mm()에서 잡았던 참조(mmdrop())를 내려놓아야 한다.
tsk->mm = NULL;
mmgrab_lazy_tlb(mm);        /* 아직 active_mm인 mm의 수명 확보 */
enter_lazy_tlb(mm, tsk);
mmdrop(mm);                 /* kthread_use_mm()의 mmgrab() 상쇄 */
만약 이 순서가 바뀌면, 다른 CPU에서 마지막 사용자가 종료되는 순간 현재 CPU의 MMU에 여전히 걸려 있는 mm이 조기에 해제될 위험이 있다. 또한 kthread_use_mm() 내부의 mmgrab()은 페이지 테이블(mm_struct와 pgd)의 수명만 보장할 뿐 실제 유저 매핑(mm_users)의 존속까지 보장하지는 않으므로, 호출자는 mmget() 등을 통해 대상 주소 공간의 유효성을 별도로 보장해야 한다.
요약
커널 스레드는 독자적인 사용자 주소 공간이 필요 없지만, CPU가 코드를 실행하려면 유효한 MMU 컨텍스트가 있어야 한다. 직전 User task의 페이지 테이블에는 이미 커널 매핑이 포함되어 있으므로, 커널은 User → Kernel 전환 시 페이지 테이블을 교체하는 대신 직전 주소 공간을 active_mm으로 빌려 쓰고 실제 MMU 전환은 다음 User task가 스케줄링될 때까지 미룬다. 그리고 빌려 쓰는 동안 주소 공간이 조기에 해제되지 않도록 참조 카운트(mm_count)나 IPI shootdown 방식으로 수명을 관리한다.
결국 mm은 태스크가 소유한 사용자 주소 공간을, active_mm은 현재 CPU의 MMU가 실제로 참조 중인 주소 공간을 뜻한다. Lazy TLB mode는 이 두 개념을 분리함으로써 불필요한 페이지 테이블 전환과 TLB flush 비용을 줄인 성능 최적화 기법이다.
출처
- Linux Kernel Documentation, Active MM
- Linux mainline, include/linux/sched/mm.h
- Linux mainline, kernel/sched/core.c
- Nicholas Piggin, lazy tlb: introduce lazy tlb mm refcount helper functions — lazy 참조 전용 헬퍼가 도입된 이유와
kthread_unuse_mm()경로
Discussion
Comments
Loading comments connects this page to the GitHub-based utterances service. Threads are separated by this post's canonical pathname.